從免費抓取到付費授權,AI 正在重新定義內容價值與產業規則
Google 開始嘗試為 AI 使用內容付費。內容平台也許終於能從 Gemini、AI Overviews 或 AI Mode 的回答裡分到一點錢,但更值得注意的是,Google 正在重新定義「內容被 AI 使用」到底值多少錢。
過去搜尋像一條高速公路,內容平台提供道路兩旁的商店,Google 負責把人送過去;現在 AI 搜尋卻更像把商品直接搬進服務區,使用者甚至不必再走進店裡。
內容還在提供價值,流量卻不一定回來,這筆價值該由誰定價、怎麼分配?Google 這次推出的 AI Contribution Pilot,可能就是第一個實驗。
千呼萬喚的 AI 內容付費授權:還是 Google 說了算
不同於 OpenAI 等 AI 業者與大型新聞內容平台簽訂一次性、高額授權合約,Google 過去一直刻意避開這類大型授權交易。根據多名熟悉此事的產業人士透露,Google 正低調測試一項以 Search Console 為基礎的付費計畫,也就是 AI Contribution Pilot。
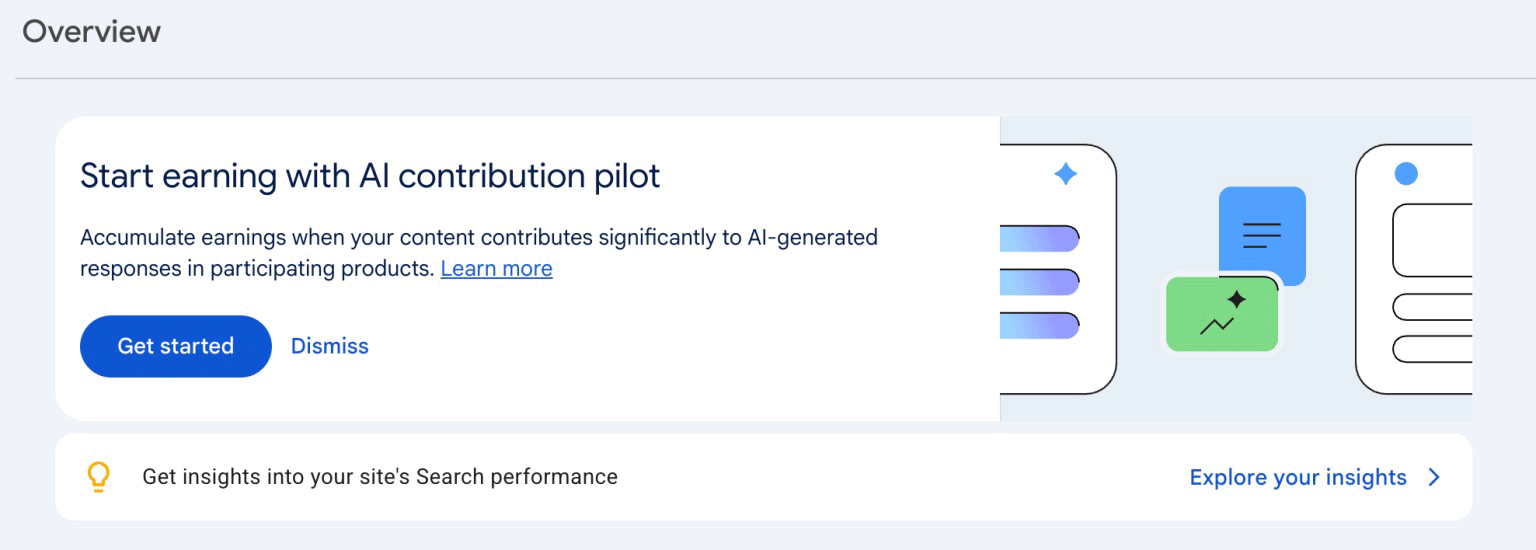
AI Contribution Pilot 主要做法是,Google 只有在判定一篇內容「顯著」貢獻了 Gemini、AI Overviews 或 AI Mode 的回答時才付錢,內容發布商可以隨時退出。據 Digiday 了解,Google 至少接觸了數十家內容發布商,這個計畫對中小型內容發布商的吸引力高過大型內容發布商。
Digiday 這篇報導後來把標題裡的 pay-per-use 改成 pay-per-value,這個改動最能說明問題在哪。按使用量算,內容發布商至少數得出內容被用了幾次;按價值算,就得先有人判定每一次使用值多少,而這個判定目前在 Google 手上。Google 官方公開的說法停在「正在探索新的合作與價值交換模式」,計算方式沒有公開。
AI 使用內容付錢與否,已升級為國家競爭力命題
2026 年 9 月,美國川普政府正式介入 OpenAI 與《紐約時報》的版權訴訟,向紐約聯邦法院提交法律意見,支持 OpenAI 使用受版權保護內容訓練大型語言模型,並主張這類行為具有「高度轉化性」,可納入合理使用(fair use)範圍。
這場官司的核心,AI 公司拿媒體內容訓練模型,到底要不要付錢?
《紐約時報》認為,OpenAI 未經授權使用數百萬篇新聞內容建立產品,理應支付授權費;美國政府則把問題拉高到國家競爭力層次,認為若因版權限制 AI 訓練,可能影響科學發展、經濟與國安。但這不代表 OpenAI 已經贏了。政府提交的只是法律意見,不是法院判決,而且美國法院目前對 AI 訓練是否屬於合理使用,仍存在不同判斷。如果未來法院普遍接受「AI training 屬於 fair use」,那麼新聞媒體想單靠「內容被拿去訓練」要求 AI 公司付費,法律籌碼可能會愈來愈少。加州也已有兩件早期判決認定,用版權作品訓練 AI 屬合理使用。若這套觀點成為主流,談判重心可能轉向需要持續更新、即時取用的場景。
Cloudflare 支持網站主對抗 AI 免費抓取內容
Cloudflare 是全球大型 CDN 與資安服務商。
Cloudflare 將 AI bot 從單一「封鎖或允許」模式,改為依用途分成 Search、Agent、Training 三類,讓網站經營者分別管理。自 2026 年 9 月 15 日起,新加入 Cloudflare 的網站在有廣告的頁面上,Training 與 Agent 預設封鎖,Search 則預設允許。Cloudflare 也新增 content use 控制,區分即時使用、引用與完整重製,並透過 robots.txt 傳達網站對 AI 使用內容的偏好。
法律上的籌碼變少,Cloudflare 這類基礎設施卻讓內容平台多了一個技術槓桿:
即使法律不要求 AI 公司先付錢,內容發布商仍然可以決定 AI 能不能 crawl、能不能 train、能不能讓 AI Agent 直接把內容業者的內容拿走。
過去 Google crawler 的交換很清楚:你抓我的內容,我得到搜尋流量,再把流量變成廣告或訂閱收入。Cloudflare 自己也點出,生成式 AI 正在破壞這個交換關係:內容被取走,但使用者未必再回到原網站。
AI 爬內容可以拆成五種用途
拿音樂授權來比方:同一首歌,電台播放、廣告配樂、KTV 點唱各談各的,用在哪裡決定怎麼收錢。AI 授權也開始這樣拆,一篇報導大致可能被用在五種地方:
- 模型訓練:Hachette、Cengage、Elsevier 等原告控告 Google,指 Google 未經許可,用這些書與上架到 Google Play 的書籍訓練 Gemini。案子還沒判,原告主張的是:為某個用途提供的內容,不能被拿去做另一種用途。
- 即時 grounding:grounding 是模型回答時先查外部資料再生成。據 Press Gazette 報導,Google 與英國內容發布商的兩年期協定涵蓋 AI 訓練、grounding 與 AI Mode,Guardian、FT 都參與,即時取用已經被單獨寫進權利範圍。
- 產品內使用:據 WSJ 報導,Amazon 與紐約時報的合約讓 Amazon 能在 Alexa 等產品使用紐時內容,也能用來訓練自家模型。一份合約同時包了輸出與訓練兩種用途。
- 企業 RAG:RAG 是讓企業 AI 先檢索受控內容再生成內容。Snowflake 的 Cortex Knowledge Extensions,讓企業在 Snowflake 環境裡查詢內容發布商的付費內容,內容業者不必交出原始 feed,內容也不會被拿去訓練;據 Digiday 報導,已有未具名內容發布商在上面簽下六位數美元的合約。
- 代理人存取:付費訂戶改用 AI 代理人來讀內容。Le Monde 幾乎擋下所有機器人,下一步在研究付費讀者改由 AI 代理上門時怎麼辦;技術長 Paul Laleu 正在觀察 MCP 與 OAuth 類的早期標準,希望代理能告訴網站「這位使用者已登入、已付費」。
五種用途可能疊在一起,一份合約就可能同時包了訓練、查找與摘要,所以要談的是用途的組合,以及哪一種不能跨到哪一種。機制並不玄:每定義一種用途,合約就多一項可以放行、拒絕或另外報價的條件;要變成技術上的開關,還得先認得出是誰、拿去做什麼。
問題是,內容業者往往認不出是誰來抓、拿去做什麼,這是跟 AI 公司談判前得先補上的缺口。
就算 AI 真的願意付使用費:誰來記帳?
一篇文章算不算「顯著貢獻」,誰判定?同一段內容被摘要、交叉驗證、再轉給代理,算一次還是三次?月底那個數字,內容業者拿什麼對帳?
傳統平台的帳至少查得到,媒體可以拉出平台的數字自己算一遍;AI 授權若按「展現出的價值」計費,就得先問誰定義價值、誰量測、誰驗證。公式不公開也可能只是量測本身很難,目前證據不足以判斷 Google 的動機。可以確定的是,計量、驗證與付款都在買方手上時,賣方只能核對最後的金額。
早期參與者形容,這筆錢跟廣告收入比起來只是零頭,有內容發布商主管更直說 Google 開的價碼太低,不值得加入。還有一層顧慮:一旦參加,Google 日後就能拿來證明自己已經付過錢,內容發布商下一輪談判的籌碼反而變少。
三種付費方式的差別,在於內容發布商看得到多少:
- 按價值付費:Google 試行採用這種。內容發布商只看得到每月一個金額,付不付、付多少由平台判斷。
- 按使用次數付費:Cloudflare 的 Pay per Use 還在實驗。每次使用都觸發付款,理論上付款能對得上使用次數。
- 整包授權:Amazon 和紐時的合約屬於這種。價格和條款簽約時就談定,雙方都看得到。
退出也有成本的,在英國 CMA 要求下,Google 在 Search Console 推出退出 AI 搜尋功能的開關,表示退出不會影響傳統搜尋排名,同時會提供更多 AI 曝光資料,希望說服考慮退出的內容發布商留下。
據 Reuters 報導,歐盟反壟斷機關正在詢問內容發布商,這套退出機制能否讓他們在不犧牲搜尋排名的情況下拒絕 AI 使用。開關有了,退出之後要放棄多少曝光與資料,還是得由內容發布商自己評估利弊。
全球 AI 內容授權使用付費案例
內容業者和 AI 公司之間,已經陸續談成幾筆交易。本刊關注的是兩件事:內容價格由誰決定、多久重談一次。價格可能按整包、按客戶價值,或像 Reddit 想爭取的那樣,按內容對 AI 回答有多重要來收。
- 交易形態:多年期授權合約,按年付款
- 計價方式:據 WSJ 報導,每年至少 2,000 萬美元、最高 2,500 萬美元
- 權利範圍:產品內使用與模型訓練
- 誰定價:雙方簽約時議定
- 交易形態:2024 年簽約,Google 取得 Reddit Data API 的即時結構化內容
- 計價方式:據報導每年約 6,000 萬美元的固定費用
- 權利範圍:搜尋顯示與模型訓練
- 誰定價:原本雙方議定固定年費,Reddit 想在續約時改成按價值計價
- 交易形態:Axios 自己賣的即時新聞資料流,直接送進客戶的系統
- 計價方式:年費,依客戶公司規模與管理資產開價,一簽兩年
- 權利範圍:投資機構付年費,就能即時收到 Axios 的財經新聞
- 誰定價:Axios 自己開價,客戶越大付越多
台灣內容發布商的機會點
把這些案例搬回台灣,條件得先重設。本刊 233 期提過,台灣沒有 Apple News 這類分潤平台,LINE Today 等新聞聚合入口也不分潤給內容發布商。台灣媒體也少有紐時那種品牌與訂閱規模,靠拒絕權談判很難直接複製。能搬過來用的,是談判前先把控制條件準備好:
- 先分類爬蟲用途:Cloudflare 已把搜尋、訓練與代理拆開設定,對願意遵守 robots.txt 的爬蟲,可以拒絕訓練、保留搜尋曝光。指令靠對方遵守,要強制擋下還得靠網路層封鎖;先決定每一類放不放行,後面才有價格可談。
- 按用途分級報價:訓練、即時查找、產品內使用、企業 RAG、代理存取的風險各不相同,報價要逐項寫清期間、內容範圍、更新頻率、輸出形式,以及能不能轉授權。
- 把計費方法明確寫進合約:最低保證、分用途的使用紀錄、內容發布商的查核權,以及退出後會不會影響搜尋曝光或合作資格,這四項都要在簽約前問清楚。
- 媒體集體談條件:澳洲 8 月通過新制,對大型社群與搜尋平台加收一筆費用;平台若跟新聞媒體簽付費合作,可以拿來抵這筆費用,但合作對象至少要涵蓋 8 個不同的媒體集團。政府收到的費用還會撥 5%,補助沒拿到合作款的新聞機構。這讓平台沒辦法只跟一兩家大媒體談完就交差;台灣若要談議價制度,「最少要涵蓋幾家」這個設計值得參考。
結論:下一場 AI 內容戰,爭的是定價權、查核權與拒絕權
AI 內容授權真正的問題,已經從「AI 公司該不該付錢」,往前推進到「誰有權決定內容怎麼被用、怎麼計價,以及怎麼查帳」。
Google 的 pay-per-value、Cloudflare 對 Search、Agent、Training 的分類,以及內容業者陸續談出的授權案例,都在指向同一件事:
未來內容不會只有一個價格,而是依照訓練、即時查找、RAG、產品內使用與代理存取,拆成不同權利與價格。
對台灣內容業者來說,與其等一張 Google 或其他AI 強權開的支票,不如先把自己的規則訂好。哪些用途可以免費、哪些必須授權、哪些必須付費,都要先說清楚。同時爭取使用紀錄、查核權與退出權。當 AI 平台同時掌握流量、計量與定價,內容業者若連自己的使用條件都沒有定義,就很難談妥內容價格與價值。(by Brick)
【活動分享】
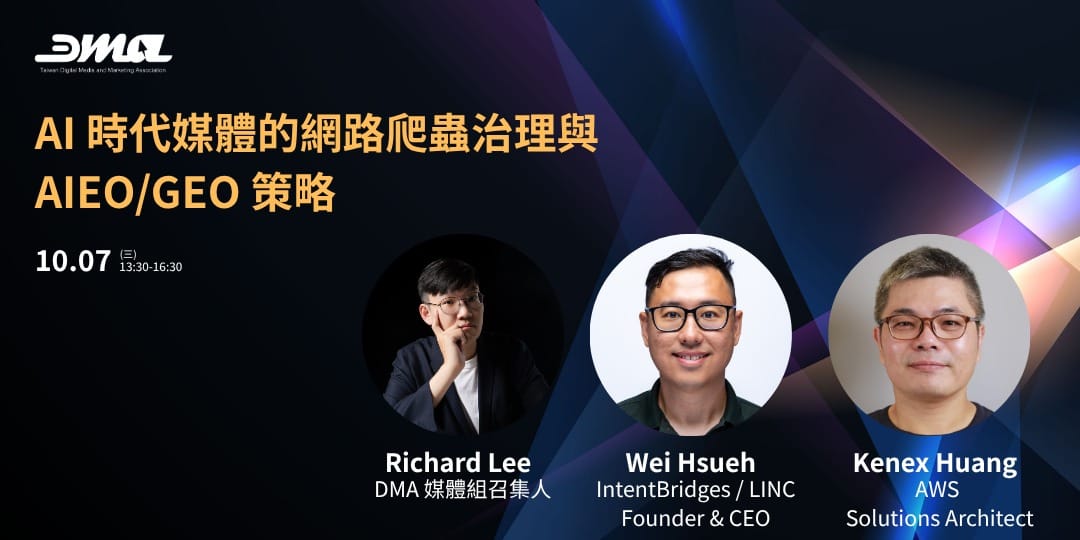
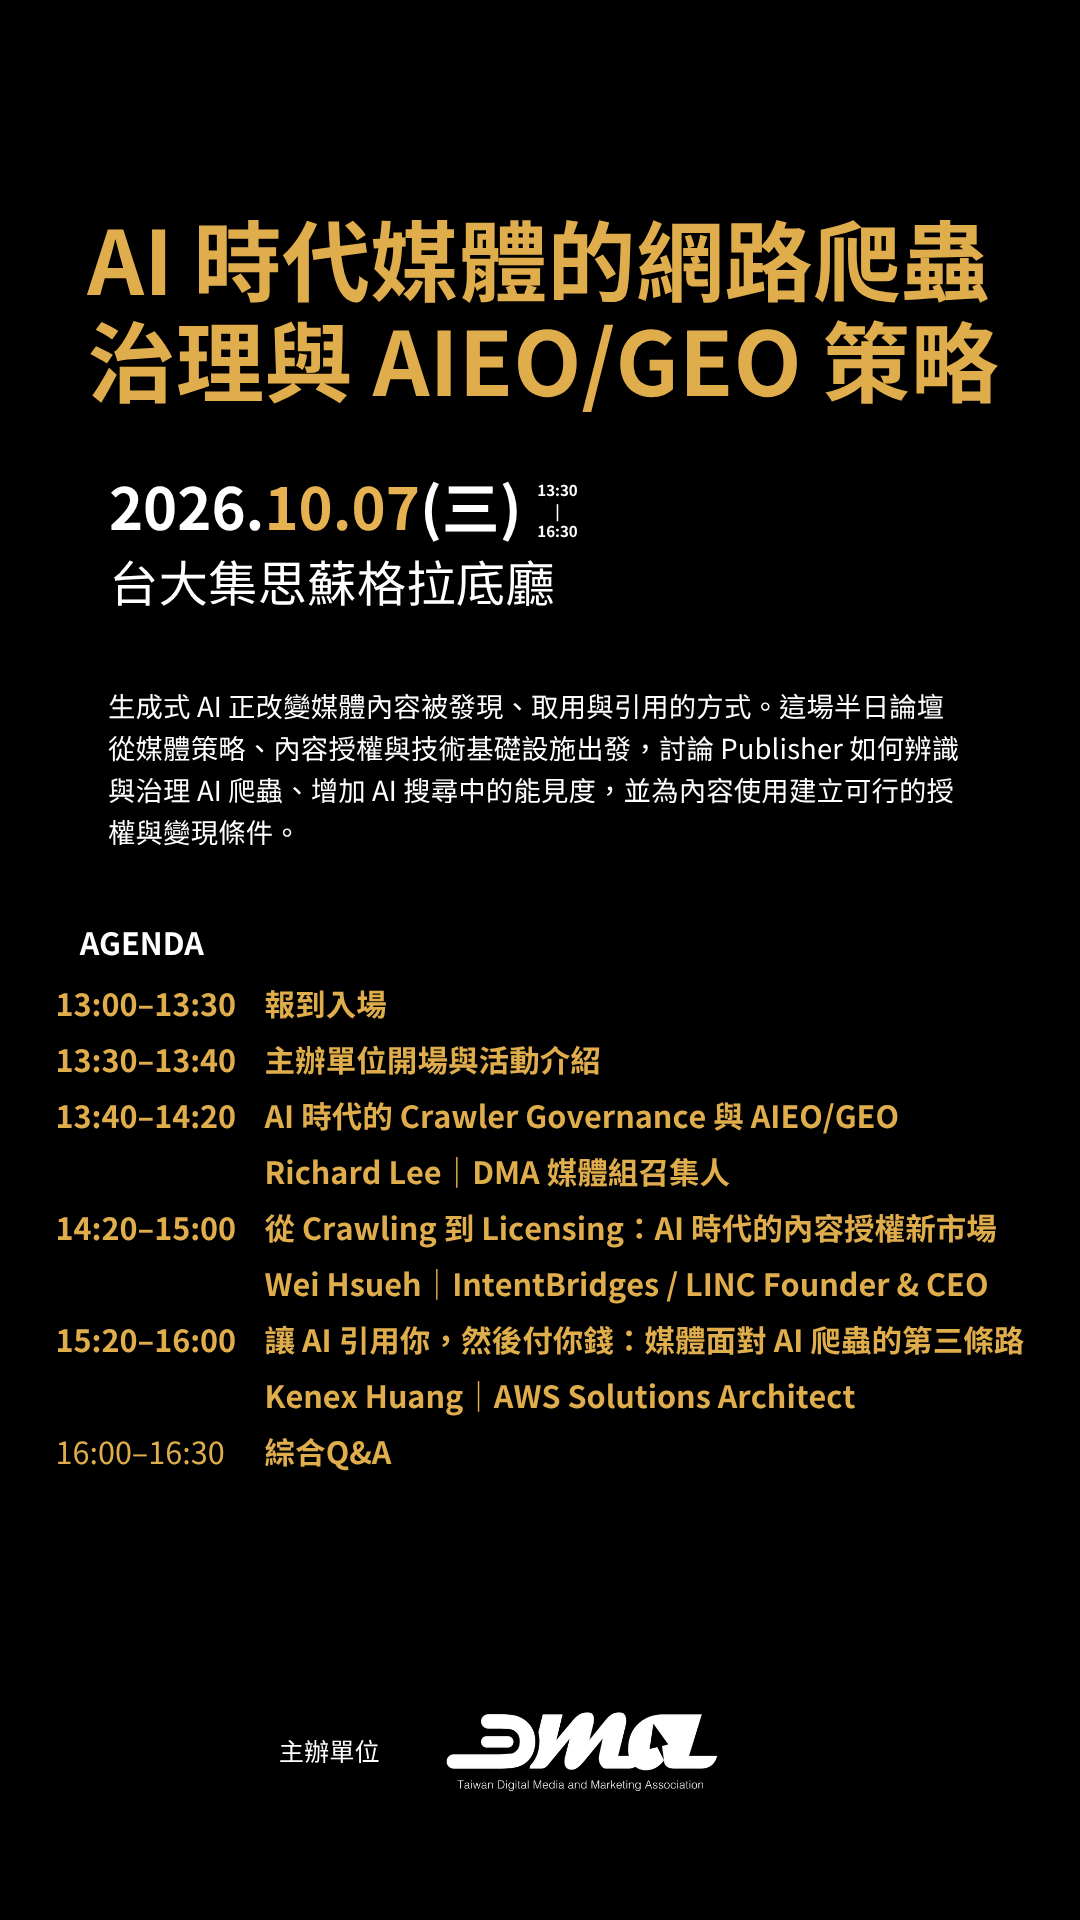
如果你是本刊的忠實讀者,也同樣關注 AI 時代下的內容爬蟲治理、AIEO 與 SEO 變化,那這場論壇值得特別留意。
本次活動由 DMA 協會主辦,本刊主編 Richard Lee、編輯 Wei Hsueh 將針對相關議題進行分享,也邀請了技術專家共同與會,從內容治理、搜尋變化到 AI 帶來的新挑戰,進一步討論內容產業接下來該如何應對。
如果你也正在思考 AI 如何改變內容被搜尋、被引用與被使用的方式,千萬不要錯過這場交流機會。報名連結
- 時間:2026.10.07 (Wed) 13:30 - 16:30 (GMT+8)
- 地點:台灣台北市大安區學府里羅斯福路四段 85 號 B1 集思台大會議中心蘇格拉底廳
- 主辦單位:台灣數位媒體應用暨行銷協會(DMA)
【參考資料】
- Google rolls out pay-per-value AI licensing program to publishers
- Google's ongoing commitment to supporting the information ecosystem
- Your site, your rules: new AI traffic options for all customers
- Have it both ways: stay discoverable in search while disallowing AI training
- What The New York Times looks for in AI licensing partnerships
- Axios preps new Axios Direct feeds for AI models, agents as revenue tops 2026 goal
- On Neutral Ground: Why Content Licensing Needs Independent Settlement And Verifiable Payments
- Treasury Laws Amendment (News Bargaining Incentive) Act 2026